[논문 리뷰] RT-Trajectory: Robotic Task Generalization via Hindsight Trajectory Sketches
한줄 요약: 해당 논문은 task generalization을 위해 trajectory 기반 새로운 policy conditioning 방법론을 제안합니다.
Introduction
일반화된 로봇 policy를 구축하는것이 대세인 요즘 어느 policy를 사용자가 원하는지에 대한 conditioning을 어떻게 할지 다양한 방법이 논의되어 왔습니다.
- one-hot task conditioning
- 어떤 task인지 mode를 정해주는 방법으로, task 사이에 일반화 불가능
- 자연어 conditioning
- 요즘 핫한 VLA로, 언어로 설명하기 어려운 task들의 경우 수행하기가 어려움
- 목표 image/video conditioning
- 위 두 방법론보다 general하지만 학습이 어렵고 실제 inference시 사용이 어려움
특히 저자들은 예시를 하나 들면서 기존 conditioning 방식의 문제점을 제기합니다.
물체를 줍는 명령이나, 빨래를 개는 명령이나 하는 행동은 모션 상에서는 비슷하지만 자연어 임베딩이 다른데, 그렇다면 이것은 로봇 policy에게 있어 ‘새로운 task’로 간주되지 않을까?
따라서 저자는 대충 (coarse) 그린 trajectory를 policy conditioning에 적용하기로 합니다. trajectory 기반의 policy network를 구성해두면, 얘는 language 보다 더 실제 모션에 가깝기 때문에 expressive 하고, 목표 image/video 보다는 inference시에 사용도 쉽고 학습 데이터를 구성하기도 쉽다는 이유에서 였습니다.
Realated Work
초기 로봇 generlization은 단순히 특정 task를 수행하는 과정에서 생기는 변수들에 일반화 (2d control, 시각 분포 변화등)를 하는 연구가 있었습니다. 이후에는 아예 새로운 object 및 language, background와 방해 요소등에 최적화하는 연구가 있습니다. 본 연구에서는 기존에 크게 구분하지 않았던 conditioning generalization 관점에 대해서 설명합니다.
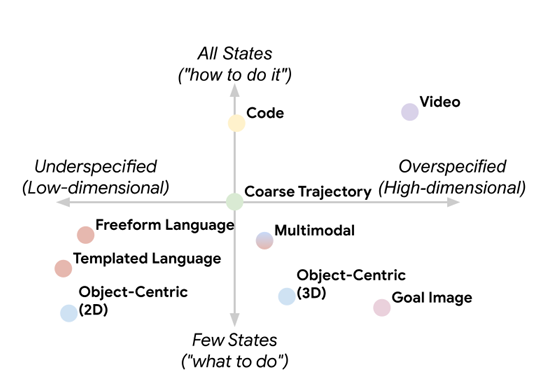
다음은 모달리티별 로봇 policy 조건을 얼마나 섬세하게 표현하고(Overspecified vs Underspecified), 또 얼마나 세부 step으로 표현할 수 있을지 (All states vs Few states) 좌표로 나타낸 그림입니다. 최근 핫한 VLA의 경우에는 왼쪽 아래 Freeform language에 위치해 있는걸 볼 수 있습니다. 이쪽인 이유는 중간 과정을 어느정도 설명하지만 action policy를 구체적으로 정하지는 않기 때문입니다. 또한 goal image의 경우에는 섬세하게 마지막 위치를 알려주지만 중간 과정을 설명하지 않기 때문에 오른쪽 아래에 위치합니다.
RGB video는 우측 최상단에 위치하지만 구하기가 어렵다는 단점을 제시했는데, 사실 논문이 발표되고 최근에 나온 VERA 연구에서는 generative model을 학습시키는 것으로 이러한 문제를 해결한 상태입니다. 아무튼 본 저자는 가운데에 위치하여 너무 세세하지도 않으면서도 너무 표현이 적지 않은 중간에 위치해 있다고 어필하고 있습니다.
Method
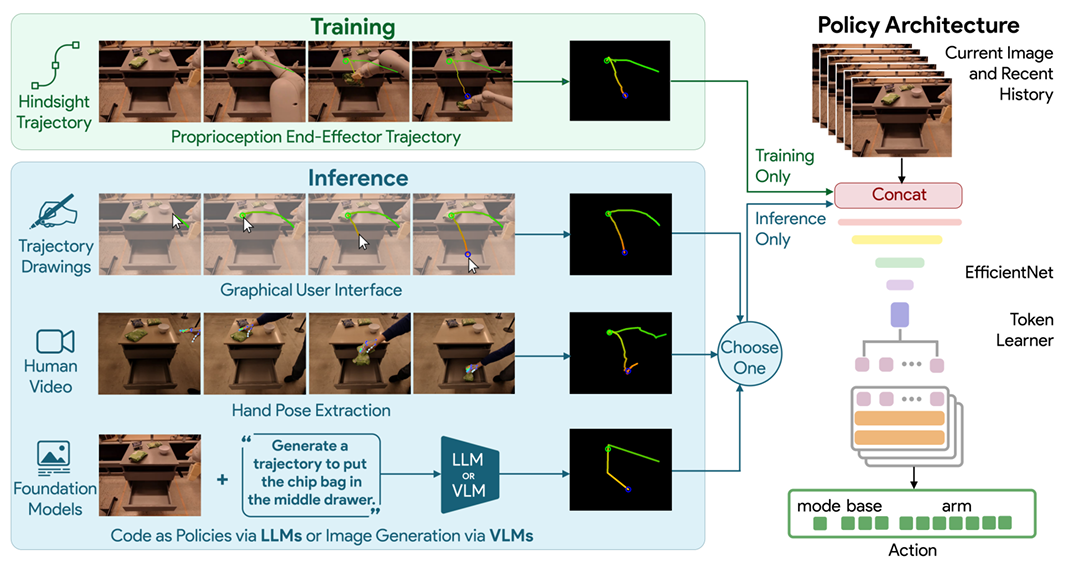 Overview
- 기존 데이터셋에서 end-effector 위치만을 따서 trajectory 만들기
- imitation learning을 통해 trajectory를 condition으로 policy 학습하기
- inference 시에는 직접 그리거나 language로 trajectory를 생성하는등으로 policy rollout
Trajectory
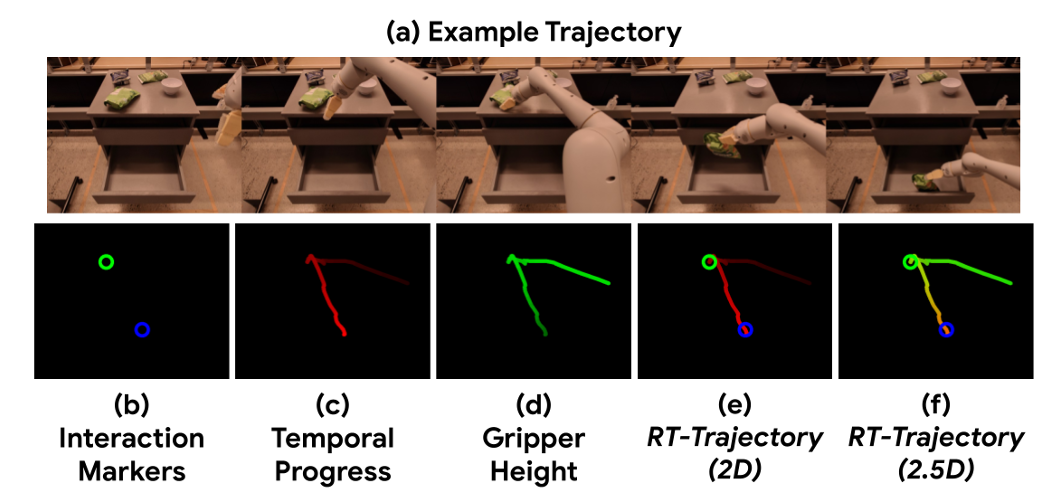
Trajectory는 탑뷰 시점에서 바라봤을때를 projection 해서 여러 요소와 함께 구성됩니다.
상호작용 마커는 (b)로, gripper가 object를 잡고 필때의 시점을 threshold로 계산해서 해당 위치를 초록색과 파란색 (닫을때 초록색, 열릴때 파란색)으로 표시합니다. 구체적으로는 다음과 같은 수식으로 열고 닫는 event를 검출합니다.
\[\delta_t = \^p_t - p_t\]이때 ^p_t는 원하는 그리퍼 값, p_t는 현재 실제 세계의 그리퍼 값입니다.
\[(\delta_t<0 \space {OR} \space \^p_t < \epsilon ) \space {AND}\space (\delta_{t+1}>0\space{AND}\space\^p_{t+1}>\epsilon)\]해당 식의 첫번째 항은 명령보다 더 벌어졌거나 OR 애초에 닫으라는 명령이 없는 상황. 두번째 항은 명령보다 덜 닫혔고 AND 닫으라는 명령이 내려진 상태. 이 두가지의 t시점을 알면 t시점이 닫으려고 명령하는 시점임을 확인할 수 있고, 이걸 그대로 반대로 역전시키면 열라고 명령하는 시점 또한 구할 수 있습니다.
시간에 따른 진행은 (c), (d)로 빨간색은 t시점에 따라서 gradient를 주고, 초록색은 end effector 기준 상대 높이를 기준으로 gradient를 주었습니다.
마지막으로 (e)는 높이 정보를 주지 않은 2D고, (f)는 높이 정보까지 포함해 구성한 2.5D 정보 표현 방식으로 명명했습니다.
Policy learning
model에 기존 input image와 함께 trajectory image를 추가합니다. 이 상태에서 input에 대한 action pair와의 log-likelihood를 최소화 하는 behavior cloning을 수행합니다. 특히 RT-1을 기반으로 모델이 만들어졌는데, RT-1의 FiLM layer를 제거하고, 단순히 input에 traejectory token을 추가하여 모델을 구성하였습니다.
실제로 inference 시에는 GUI를 사용해 인간이 직접 trajectory를 그리거나, 이미지 generation model을 써서 생성하거나 LLM code에 따른 end effector 위치를 미리 예측해서 그리는등의 방식을 사용했습니다.
Experiments
RQ1) training dataset 이외에도 policy 일반화가 됐을까?
RQ2) test time에 인간이 직접 그리는 trajectory를 잘 따라갈 수 있을까?
RQ3) 특징은 뭐가 있을까?
RQ4) training data부터 얼마나 모션이 다른지 잴 수 있을까?
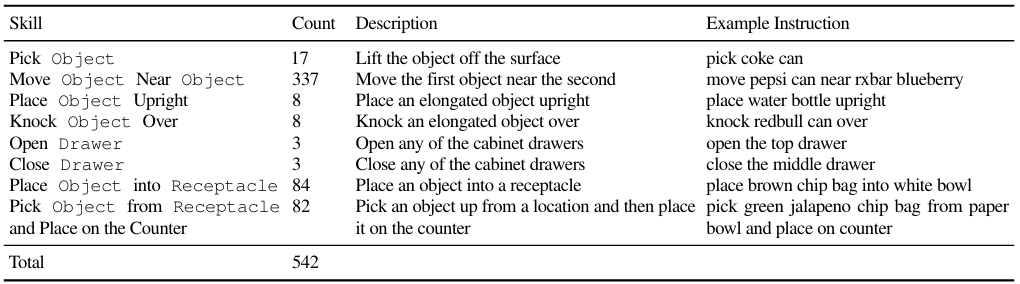
또한 training에는 RT-1 데이터만 사용되었습니다. 학습에 포함된 task는 다음과 같습니다.
저자들이 새로 만든 task는 다음과 같습니다.
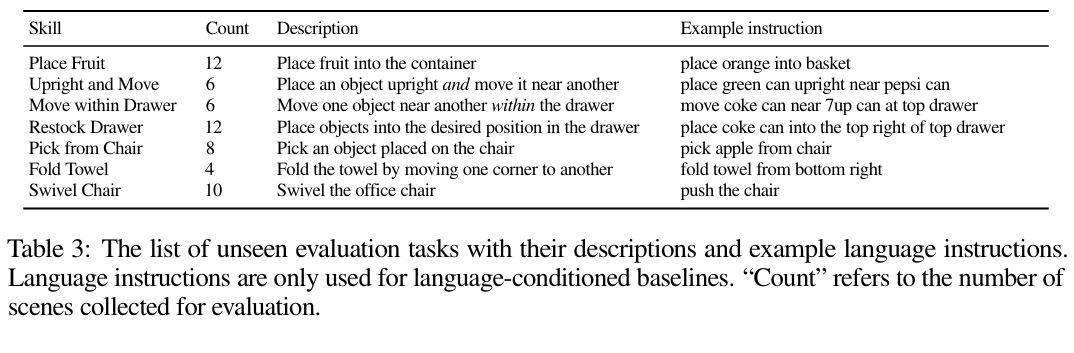
자연어로써 주어지는게 아니라 여기에 해당하는 trajectory를 그리는것으로, 이걸 그렸을때 과연 의도한대로 동작할지를 test 하는게 목표였습니다.
baseline은 RT-1, RT-2, RT-1-Goal (image goal) 이었습니다.
Result
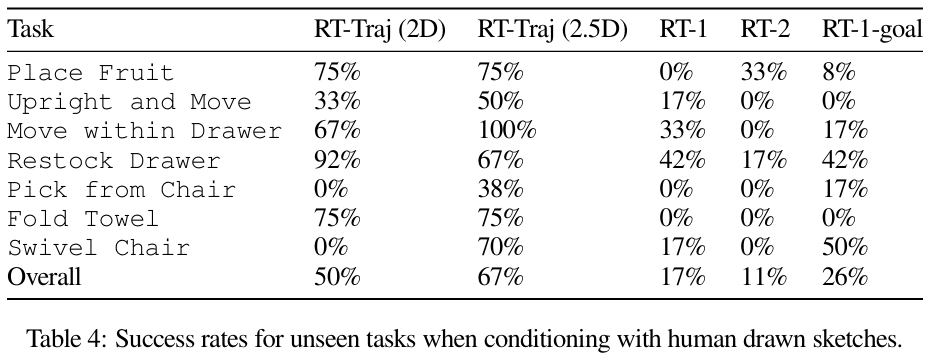
Task 성공률은 다음과 같습니다. RT-Traj (2.5D)가 제일 좋은 성공률을 보였습니다.