[논문 리뷰] Pi0.6*: a VLA That Learns From Experience
Abstract
- demonstration, on-policy collection, expert intervention을 학습시킬 수 있음.
- offline RL로 모델을 학습한다음 세부 task에 fine tuning을 수행
Introduction
- 기존 VLA는 그저 여러 로봇을 따라하기만 했다.
- 이는 강건하지 못했다. 따라서 RL을 도입하고자 했다.
Related Work
- 기존에 VLA를 RL로 향상하고자 하는 시도들이 존재하였다.
- PPO를 직접적으로 적용하거나 action head만을 학습시켰다. 하지만 우리는 간단한 RL 방식에 end-to-end 학습을 제안한다.
- Value 기반으로 DPO를 적용하거나 PPO, REINFORCE를 적용한 사례도 있었다. 하지만 우리는 policy 추출에 advatange conditioning strategy를 사용해 이러한 복잡성을 해결한다.
Prelimnaries
advanatge function은 다음과 같이 정의된다.
\[A(s,a) = Q_{\pi}(s,a) - V(s)\]원본 논문에서는
\[A^{\pi}(o_t,a_t)=\mathbb{E}\left[\sum r_{(t,t+N)}+V^{\pi}(o_{t+N})\right]-V^{\pi}(o_t)\]여기서 E는 ot, at가 주어질때의 TD lambda에 대한 기대 보상값이므로 Q_pi(s,a)에서 대체할 수 있다.
기존의 Q target과 다른점은 강건한 학습을 제공해 준다는 장점이 있다.
추가로 수학적 theorem과 KL divergence를 이용해 policy 학습을 강건하게 한다. (?)
Method
- 데이터를 수집하고 점수를 라벨링한다.
- Value function을 학습시킨다.
- 학습시킨 Value function으로 VLA 모델을 개선한다. (advantage conditioned)
Value function training
먼저 distributional probability function p(ot, lt)를 정의한다. ot는 시야, lt는 언어
해당 값은 201개의 categorical probability 와 reward를 출력한다. 해당 네트워크를 실제 보상 평균에 대해서 학습시킨다. 이를 통해 다음을 계산해 value function을 구한다.
\[V(o_t, l) = \sum{p(V=b|o_t)v(b)}\]이는 expected reward return과 동일한 의미를 가진다.
기존 Q function보다 optimal 한 방법은 아니지만 imitation learning만 사용했을때 보다 더 훨씬 강건하다.
Flow matching은 직접적인 pi(s)를 제공하지 않고, 벡터 필드를 재귀적으로 적용해 최종 action을 도출하기 때문에 기존의 log likelihood를 계산할 수 없음.
따라서 이를 우회해서 학습하는데.. 수학식?
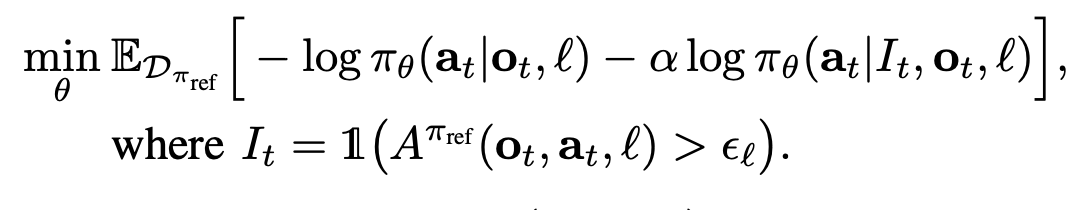
결과적으로 input에 advantage 함수가 일정 threshold인지 아닌지를 기록하는 정보를 추가한다. 이렇게 식을 구성하면 해당 식에 최적화된 policy는 advantage 함수를 일정 부분 따르게 된다.
Implementation details
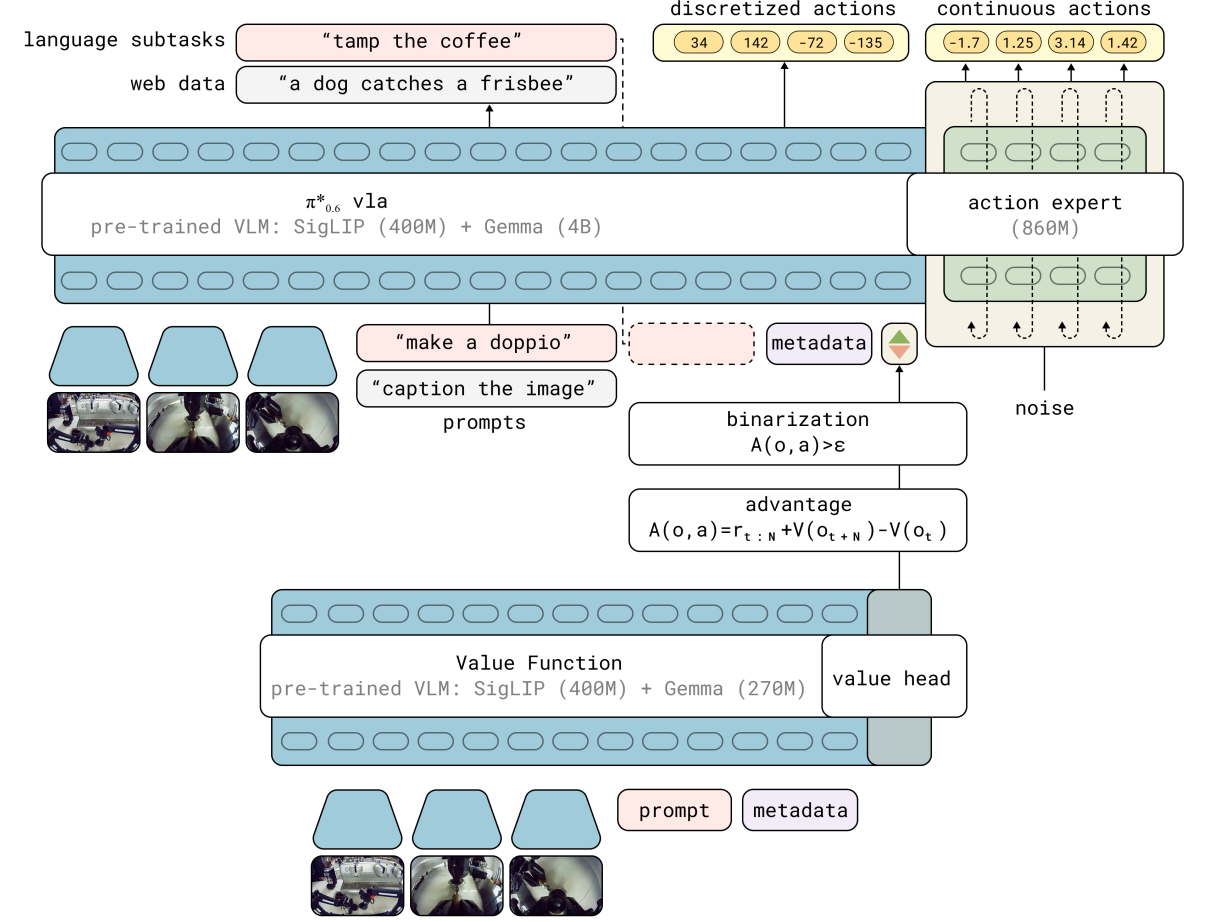
Knowledge Insulation - make a doppio → tamp the coffee 같은 행할 행동을 출력하게끔 학습 하고, vllm 모델에 역전파가 가지 않게끔 차단 한 뒤 action head를 학습
실제로 advantage function 결과를 모델에 입력할때는 advantage:True/False 이런식으로 자연어로 입력
episode 단위로 reward를 제공했는데, task 길이에 따라 차등 적용함.
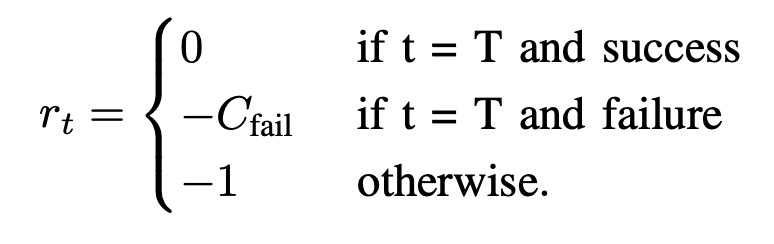
value function은 같은 gemma를 썼지만 더 작은 파라미터를 사용함.
엡실론 (advantage threshold) 파라미터는 평균 reward의 30%를 사용