[논문 리뷰] X-DiffVLA: X-Embodied Diffusion Action Heads for Vision-Language-Action Models
Insights
Research Goal
자잘한 setting에 대해서, 특히 motion arm이 1)어떻게 몸이 구성되어 있건 2)몇개가 동시에 있건 목표를 이뤄낼 수 있는 모델을 구축할 수 있다.
예를 들어 특정 연구실에서 로봇 환경을 구축하려고 한다. 하지만 기존의 데이터셋에 포함되지 않은 새로운 로봇 모델을 사용하며 여러대를 동작해야 한다. 이때 우리의 프레임워크에 morphology 정보를 입력하고 사용하면 원큐에 해결된다. 다른 방법론들은 fine tuning이 필요하지만, 우리는 zero shot을 기대한다.
Related Works
VLA 여러개를 협업하는 사례? → 모듈별 메타 정보를 제공했을때 얘네를 협업하게 한다. 이를 랜덤화 시킨 다음 학습시키면 특별히 배우지 않고도 두개의 팔을 협업할 수 있게 될지도 모른다. uni-action과 multi-action을 한번에 학습한 논문 확인
VLA여야만 하나? → VLA의 학습 도메인은 대부분 한 팔에 집중되어 있다. 특히 대규모 데이터셋을 활용하기가 어려울 수 있다. 특히 시뮬레이션 안에서의 정보를 VLA 데이터셋 파이프라인에 접목시키기 어려울 수 있다. → gensim2
Metamorph → RL 기반으로 단일 task에 최적화된 cross-embodiment 학습을 최초로 제안한 확실한 논문이다.
기타 morphology 논문들 → quad-copter, humanoid, robot arm등 domain 차이가 커서 실제로 학습에 도움이 됐을지는 의문인 논문들, 또한 ‘협업’ 컨셉에는 적합하지 않은 프레임워크가 대다수
Methods
- 벤치마크 및 학습 데이터셋 생성
- 기존의 모델들 테스트, 해봤자 반영되기 힘들것!
- 기존의 연구 대비 벤치마크 데이터셋에 더 걸맞는 새로운 모델 제안 및 테스트, 비교
- (기존의 데이터셋에 대해서 학습 및 비교)
- (현실 로봇에 접목시키고 성공률 비교)
과정: 1) 로봇이 자신의 형태를 파악하고 (팔 관절 몇개, 손가락 관절 몇개, 각각의 관절별 길이는 어떻게) 그에 맞게 자유자재로 행동할 수 있도록 학습 파이프라인과 모델을 구성 → 이때 어려운 task를 자동적으로 생성해야 하고, 그에 대한 정답을 제공해야 하는데, 이거 어떻게 할꺼임? → 일단 당장은 RL 파이프라인으로 하고, RL의 state를 현실에서 모방하는 흐름으로 가볼까요 → VLA에 접목시키려면 comment labeling을 하고 거기에 대한 RL을 설정하면 될거 같음 → gensim2 2) 추가적으로 두개, 세개의 모듈이 협업하는 시나리오까지 구성하고 통합 policy를 학습
도출물: 새로운 benchmark에 대해 강건한 우리만의 모델, 그리고 morphology들을 반영하는 선행 모델과의 비교(우리 벤치마크에서의 우수성, 기존 모델은 morphology를 id로써 사용하는 경향이 있을것.) 특히 dual 그리퍼의 협업을 제안한 선행 연구와의 비교. (우리의 벤치마크에서의 우수성, 그리고 잘 수립된 기존 데이터셋과의 비교…) 성능 검증: 1) 모든 모델에 대해 unseen morphology에 대한 real-world 로봇 데이터에 잘 학습이 되는지 확인. 이 성능이 일관되거나 좋아야 다음으로 넘어갈 수 있음. 2) 우리 벤치마크 데이터셋에 대해 확인. 다양한 상황에 검증 가능한 유일한 데이터셋이지만 직접 제안했으므로 객관성을 의심받을 수 있음. 따라서 중요하지만 보조적인 역할 3) 최종적으로 현실 시나리오에 접목해서 잘 작동되는지 확인 (external validation)
Li et al., X-DiffVLA: X-Embodied Diffusion Action Heads for Vision-Language-Action Models, RSS, 2026
Abstract
기존의 방법론들은 embodiment specific fine-tuning을 필요로 하고, 이는 generalization의 병목점이 된다.
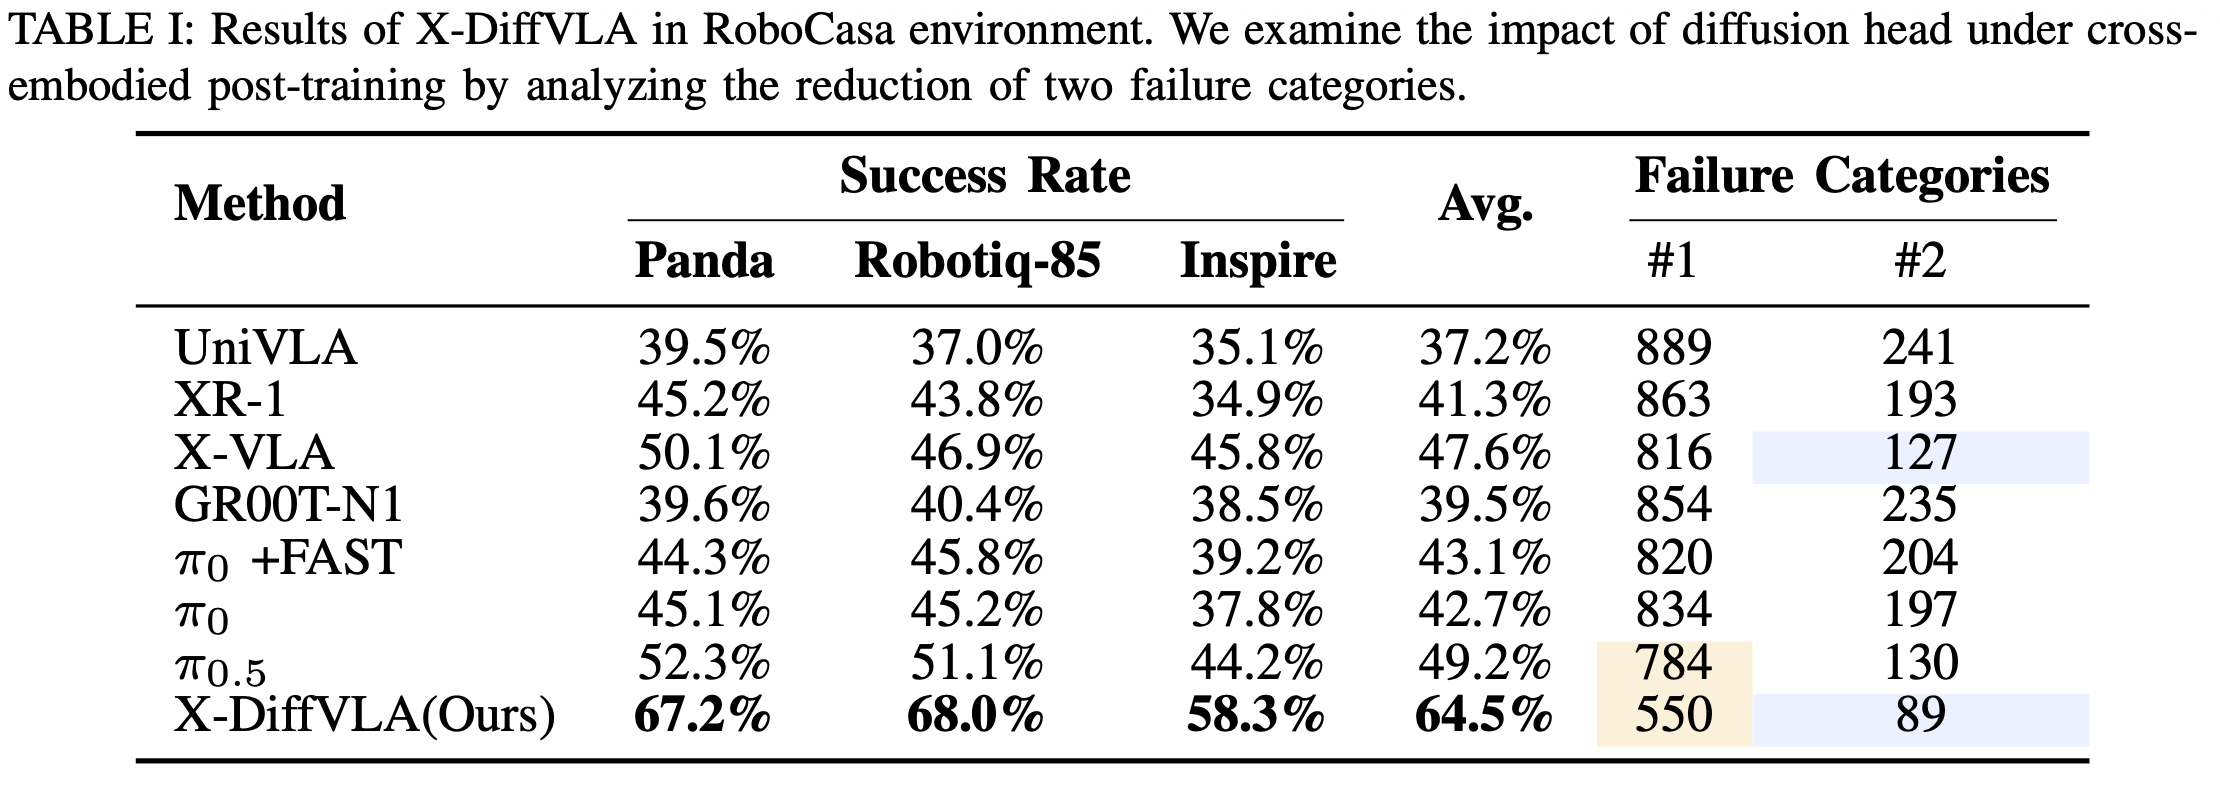
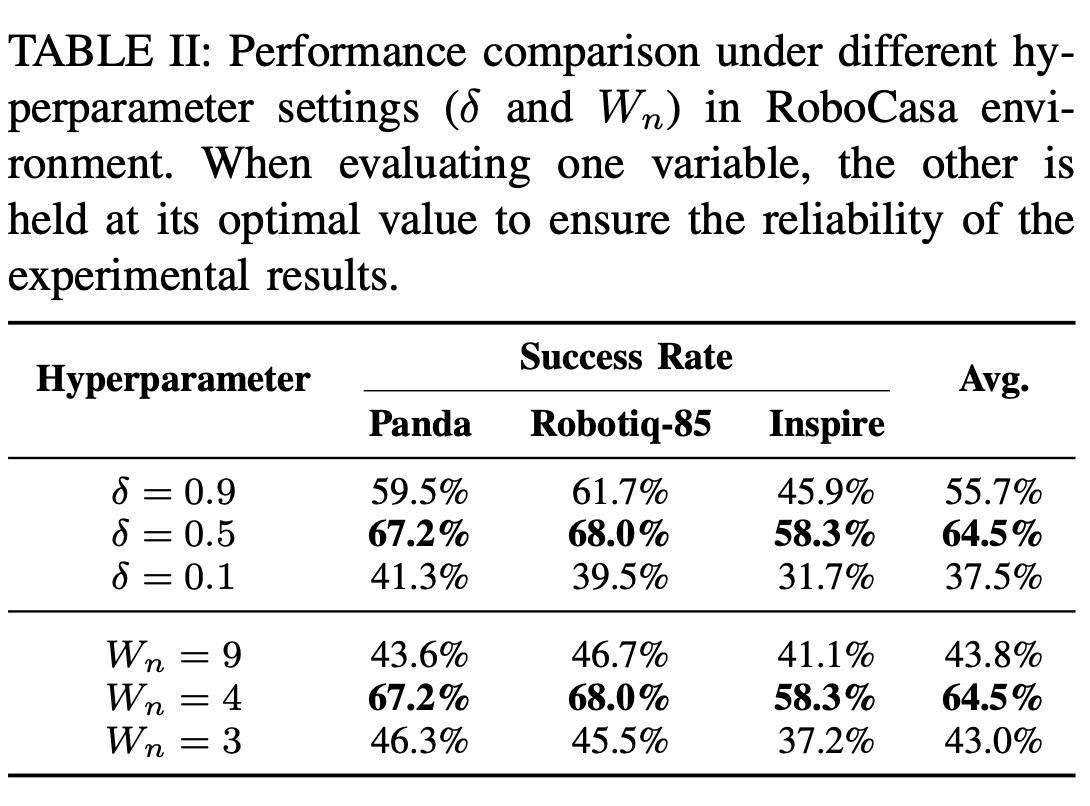
이를 해결하기 위해 embodiment forcing이라는 방법론과 morphological tree diffusion 방법론을 도입하였다. 그 결과 RoboCasa와 Issac Gym에서 SOTA를 달성하였다.
추가적으로 현실 세계에서 inference를 하면서 validation을 해봤다.
Introduction
기존의 VLA 방법론들은 morphology별 action head가 필요로 한다. 이는 여러대의 end-effectors의 활용 퍼포먼스의 악영향을 주거나 특정 task에서 살짝만 morphology를 바꿔도 제대로 동작하지 않는 문제점을 초래한다.
cross-embodied action head간 효과적인 지식 전달 또한 중요하다. 비슷한 task에 비슷한 morphology는 비슷한 행동 결과를 가질 확률이 높기 때문이다.
특히 cross-morphology gripper 데이터셋에 연구된 선행 연구는 존재한다. [Liu et al.] 하지만 VLA에 대해서는 아직 연구된 바가 없다.
또한 CLIP같이 손의 모션 동작과 여러 gripper, 손 기반 control feature를 통합했을때 성능이 향상되는 선행 연구들 또한 있었다.
따라서 이러한 발전을 VLA에 가져오고자 저자는 두가지 새로운 방법론을 제안한다. 첫번째는 embodided forcing으로 denoising process에 몸의 정보를 반영한다. 두번째는 morphological tree diffusion은 서로 다른 modality간 상관 관계를 모델이 반영할 수 있도록 도입되었다.
Preliminaries
Action heads 크게 MLP, Diffusion, Flow matching 세가지를 사용한다. 하지만 MLP는 보통 평균적인 action을 학습하는데, 이는 실제로 행할 수 있는 행동이 아닐때가 많다. Flow matching은 최근에 제안되었고 가볍지만 정교하지 않다는 단점이 있다. Diffusion이 제일 최상의 선택이다. Flow matching과 diffusion은 데이터의 분포 자체를 모델링 하기 때문에 MLP보다 더 안정적이다.
Diffusion은 Multi-Peaked Distribution에 강건 Multi-Peaked Distribution이란 데이터가 단순히 정규분포같이 어느 한 점을 중심으로 몰려있는게 아니라 여러 점에 걸쳐 모여있는 것을 의미한다. Diffusion Model은 이런 전역적인 모델링을 수행할 수 있다. Markov chain에 의해 Transition probability가 gaussian noise에 의해 정의되고, 이를 복원하는 reverse process를 neural model이 학습하도록 한다.
Monte Carlo Tree Search 해당 개념은 알파고에서도 사용된 전통적인 RL개념이자 state 탐색 및 value function update 전략이다. selection, expansion, simulation, backpropagation으로 이루어진다. selection → 노드를 선택/expansion → 선택한 노드에서 state를 추가/simulation → 해당 노드에서 rollout policy를 통해 value function 추정/backpropagation → 현재 노드부터 시작노드까지 올라가면서 value function 수정. 해당 논문에서 사용된 Monte Carlo Tree Diffusion은 state 전이 확률 및 노트 확장 계산을 diffusion으로 수행한다.
Methods
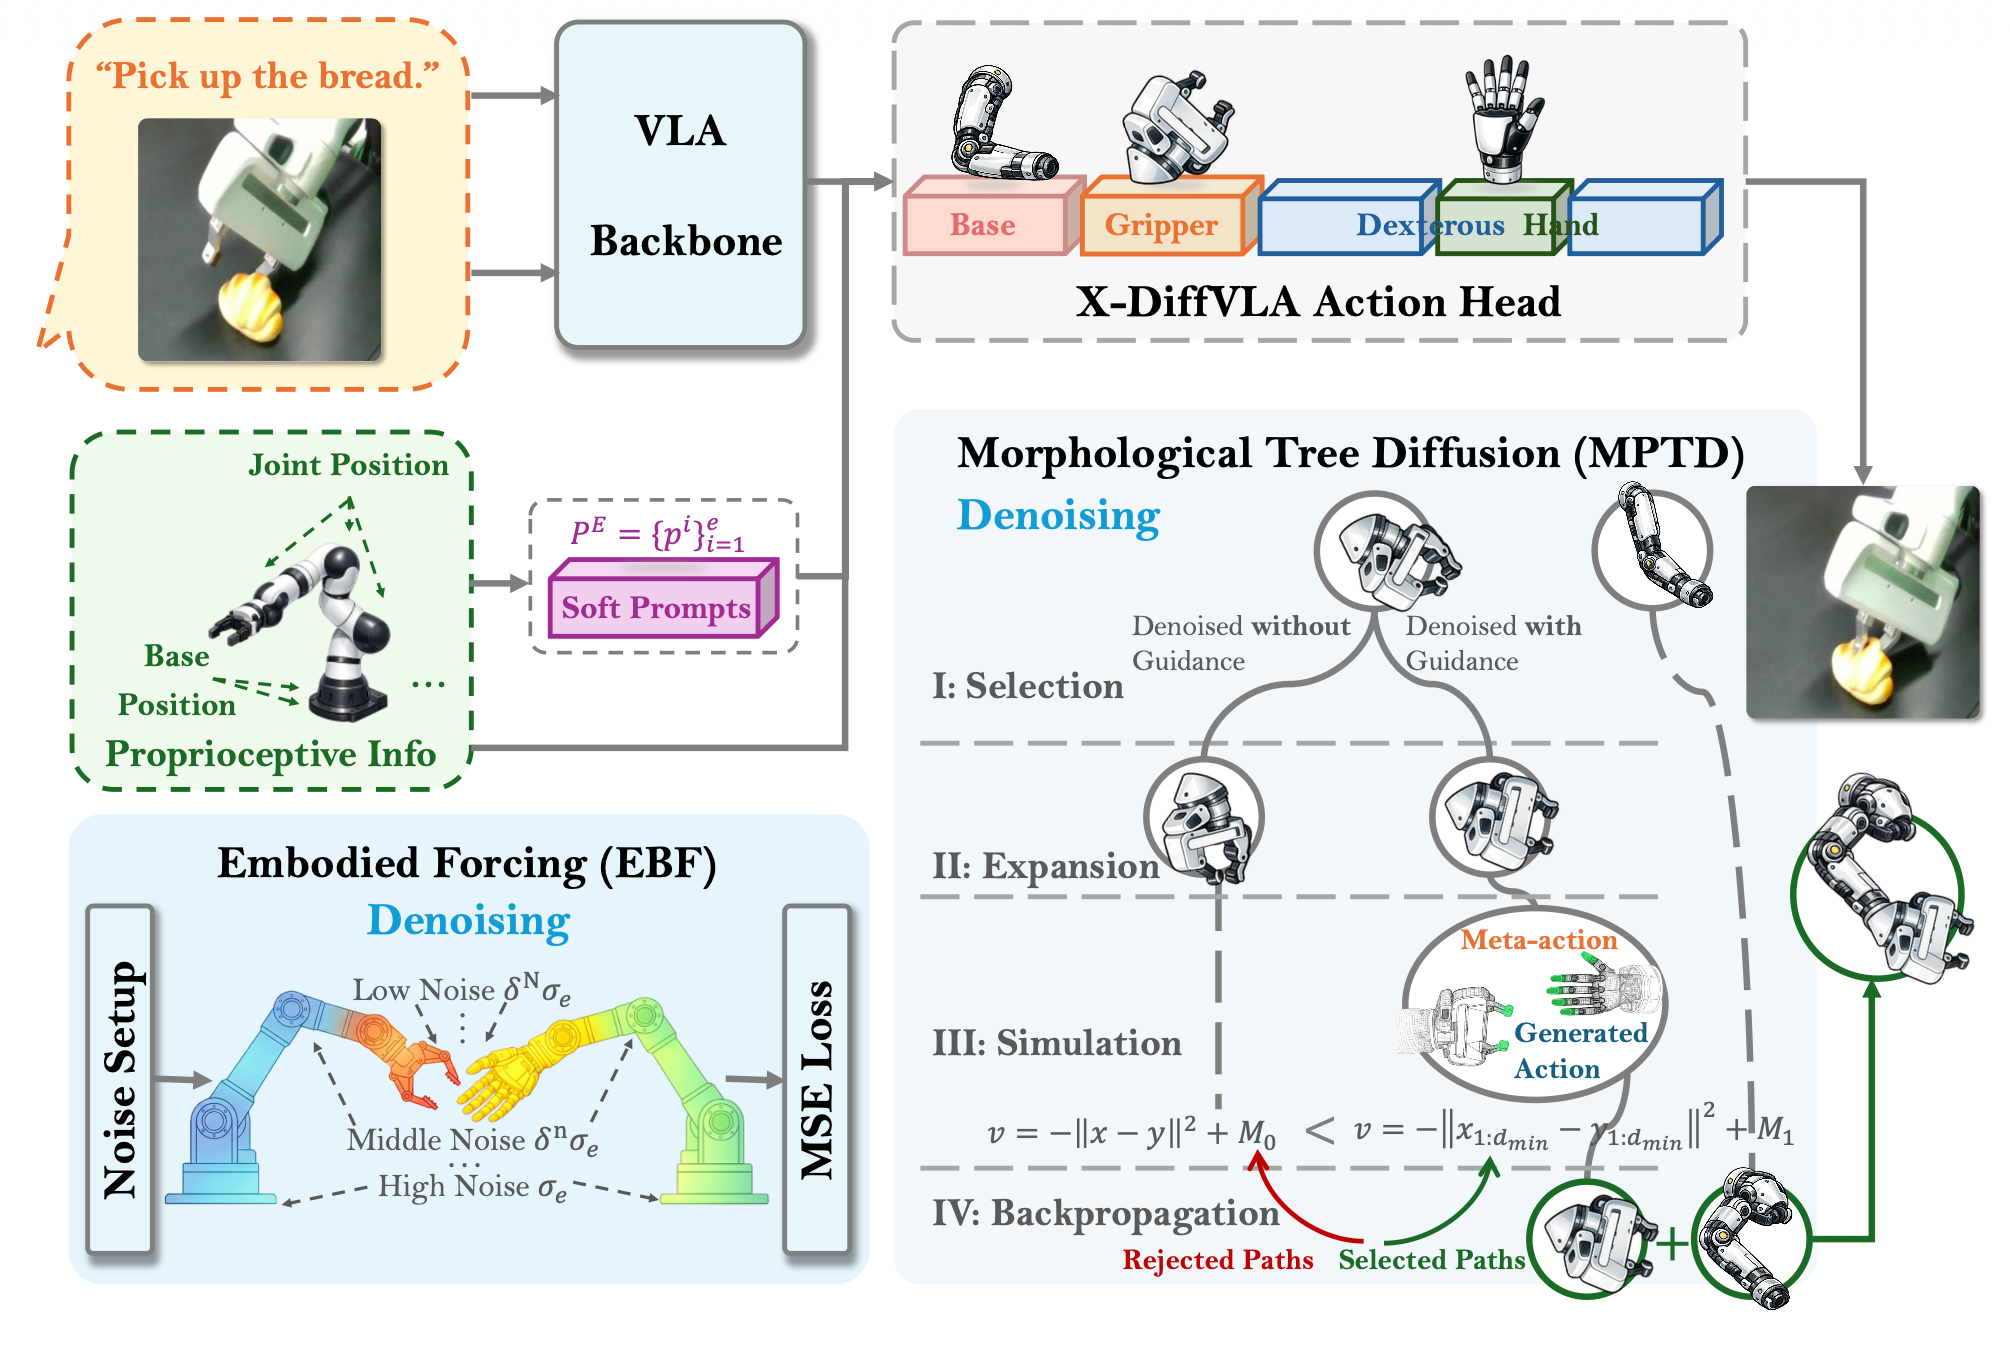
Embodied Forcing
원래 Diffusion Forcing은 시간 t별로 gaussian noise 분포를 다르게 시작하고, noise를 autoregressive하게 제거해 나가는 개념
이 개념의 방향성을 따와서, base → middle → end-effector로 세밀하게 제어해야 되는 부분으로 갈 수록 noise를 적게 주는 개념 추가.
MPTD
Inference시 같은 태스크를 수행한 다른 action의 nearest neighbor 비교 → trajectory error가 적은 쪽으로 액션을 수행 (Monte carlo tree search)
Result